


DDR5-10000 記憶體、NFC 智能 SSD
【Computex 2026 現場報導 ✅】ADATA 於剛結束的 Computex 2026 大會上,首度展出多款高效能記憶體及 SSD 全新產品。焦點包括:速度最高可達 DDR5-10,000 的 XPG NOVAKEY RGB DDR5 記憶體、具備 NFC 解鎖功能的 Urban Tapsafe 外置 SSD,以及全新旗艦級 XPG MARS 980 系列 Gen 5 M.2 SSD。此外,ADATA 亦正式宣佈推出全新企業級儲存品牌 TRUSTA,全力搶攻 AI 伺服器及數據中心市場。
全新 XPG NOVAKEY RGB DDR5 記憶體
ADATA 在本屆大會首度亮相的 XPG NOVAKEY RGB DDR5,外觀採用「無限鏡(Infinity Mirror)」光效設計,能在機箱內部呈現出層次分明、具備立體視覺深度的 3D RGB 燈效。此外,散熱片特別選用 50% 的再生鋁(Recycled Aluminum)搭配 85% 的消費後再生塑料(PCR),藉此落實綠色製造與環保理念。
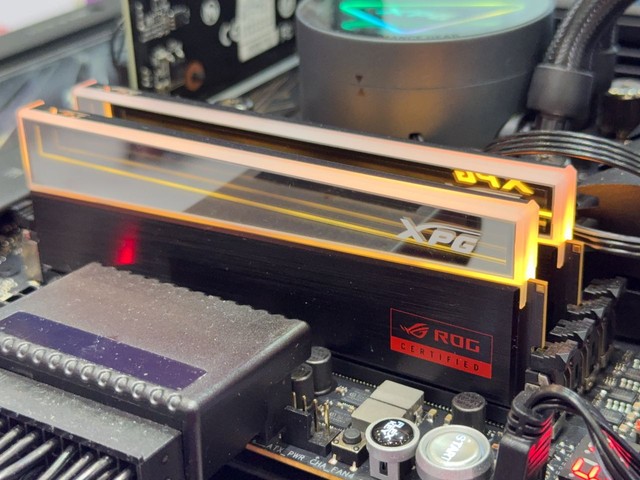
在效能方面,該系列現階段已能提供高達 8,000 MT/s 的運算速度,並具備 CL30 的超低延遲設定;而高階的 CU-DIMM 型號在現場實測中,更成功達到 DDR5-10,000 的驚人速度,超頻潛力相當出眾
XPG NOVAKEY RGB DDR5 型號將會推出 ROG Certified 版本,配合 ROG 主機板時會自動調整時脈及時序,令效能進一步提升。此外,該型號亦會推出 AMD EXPO-ULL 版本,配合 AMD 平台主機板時能自動最佳化時序,令遊戲表現得以進一步提升。
ADATA XPG MARS 980 / 980 PRO SSD
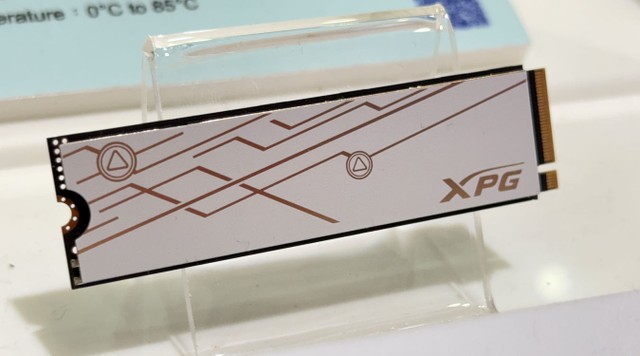
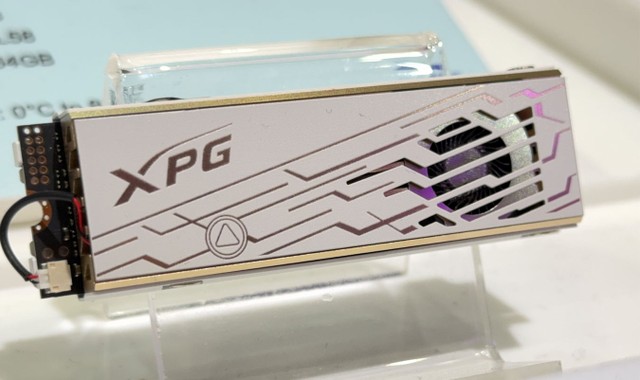
在固態硬碟方面,ADATA 帶來了全新旗艦級 XPG MARS 980 與 980 PRO Gen5 SSD。相較於前代產品,新一代 SSD 的主控晶片由 PHISON E26 升級至最新的 E28 控制器,全面支援 PCIe Gen 5 x4 通道並符合 NVMe 2.0 標準。
受益於升級至 TSMC(台積電)6nm 先進製程,該晶片的功耗與散熱表現顯著優於前代 E26,閒置功耗大幅降至 5mW,平均功耗也僅有 8.5W。
晶片內部搭載了 2 顆時脈 1GHz 的 AndesCore RISC-V N45 核心,具備 8 Channel 與 32CE 資料傳輸通道,並支援最高 4,200MT/s 速度的 NAND Flash。其最高連續讀取速度高達 14GB/s,寫入速度達 13GB/s;4K 隨機讀寫表現同樣強悍,分別可達 1,500,000 IOPS(讀取)與 2,000,000 IOPS(寫入)。
XPG LEVANTE VIEW 360 一體式水冷
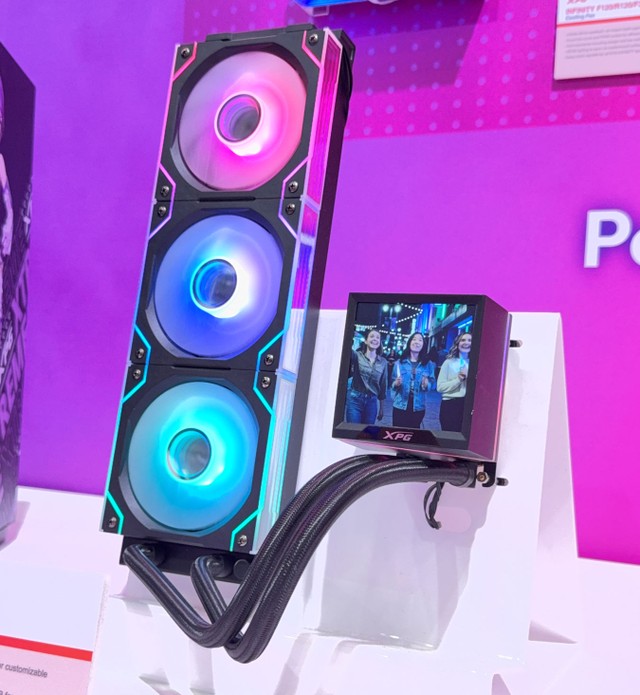
在電腦周邊與散熱領域,XPG 展出了 LEVANTE VIEW 360 一體式水冷散熱器。其水冷頭配備了 3.95 吋的可自訂顯示螢幕,解熱效能高達 320W TDP,展現出全力搶攻高階 PC 散熱器市場的野心。
全新 Urban Tapsafe 外置 SSD 系列
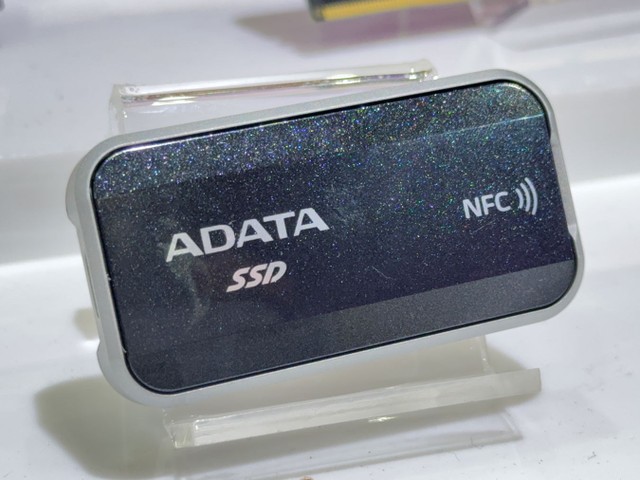
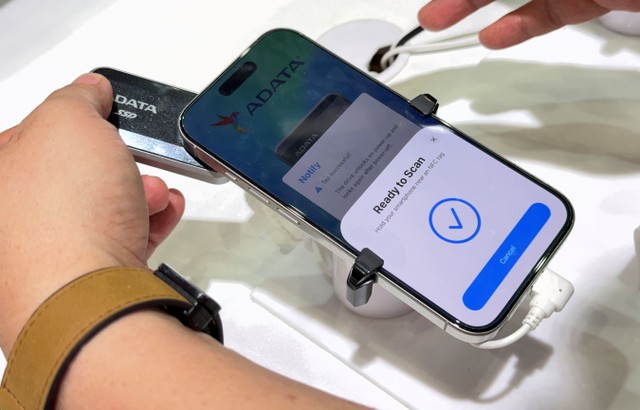
為了大幅提升外接硬碟的資料安全性,ADATA 推出全新 Urban Tapsafe 外置 SSD 系列。該系列配備 USB 3.2 Gen 2x2 傳輸介面,傳輸速率最高可達 1,900 MB/s。
此款外置 SSD 的最大亮點在於導入了智能 NFC(近場通訊)感應解鎖技術。用戶只需將智慧型手機輕觸裝置,即可透過專屬 App 完成安全驗證並讀取資料,徹底免去手動輸入密碼的繁瑣步驟,同時該系統也支援多帳戶的權限授權管理。
全新 TRUSTA 品牌登場
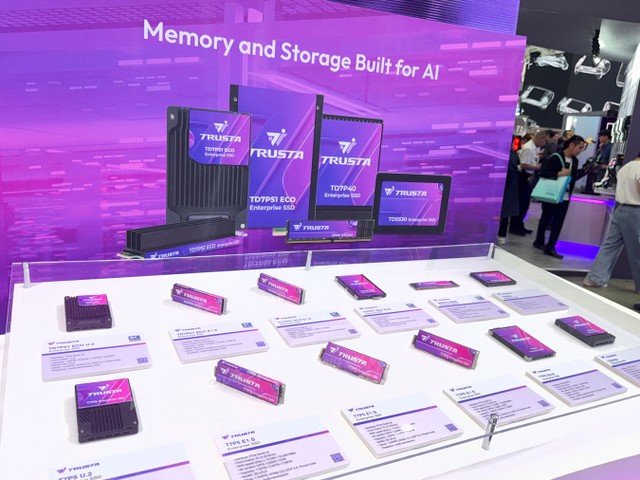
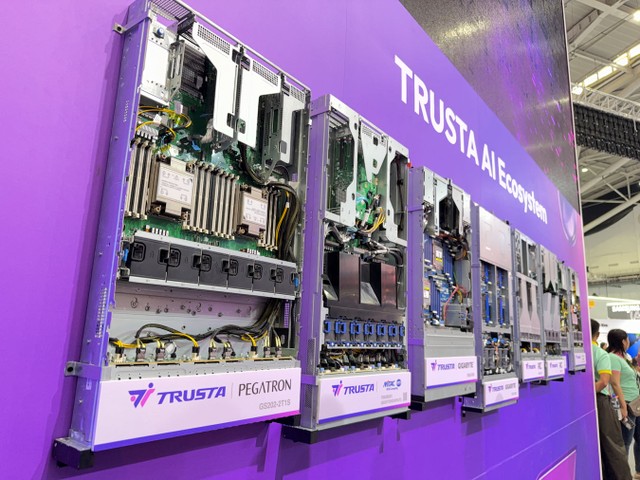
除了消費級電競市場,ADATA 也在大會上宣佈成立全新品牌 TRUSTA。與主打遊戲玩家的 XPG 不同,TRUSTA 專為企業級記憶體及儲存方案而生。
TRUSTA 首波推出了 TRUSTA AI Scaler 擴展記憶體解決方案,並隨附免費開源的 AI Scaler Toolkit 軟體工具。該方案採用「混合架構技術」,當企業在進行大型 AI 模型推論(Inference)或微調(Fine-tuning)時,若運算量超過了顯示卡本地視訊記憶體(VRAM)的容量上限,系統將會動態地將負載分流擴展至主機板的系統記憶體(DRAM)以及高速 NVMe SSD 中,有效避免運算因記憶體溢出(OOM)而中斷或崩潰。
