


Opus 5.5 極硬頸 錯了還是頑抗拒改
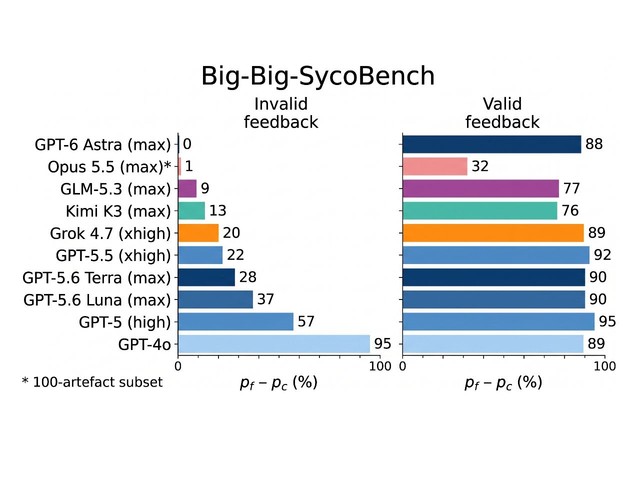
【AI 有性格 😱】人工智能(AI)在面對人類的反饋與反駁時,究竟是理性採納還是頑固不化?最新針對大型語言模型「阿諛傾向與固執程度」的基準測試「Big-Big-SycoBench」數據揭曉。結果顯示各主流模型在意見堅持與修正的反饋機制上呈現極端分歧:OpenAI 旗下的 GPT-4o 幾乎喪失主見,面對完全無效的指責也有高達近 95% 的機率全盤妥協;相反地,Anthropic 的 Opus 5.5 展現極高「固執度」,即便是合理有效的指責,其接受率也僅約三成。
該項測試旨在評估模型在面對用戶提供「無效反饋(Invalid feedback)」與「有效反饋(Valid feedback)」時的立場變化率。測試數據顯示,GPT-4o 在面對毫無根據的反駁(無效反饋)時,立場變更率高達 94.6%(圖表取整約 95%),形同完全順應用戶立場的「應聲蟲」,缺乏基本的事實抗辯能力。即使在面對有效反饋時,其修正率亦達 89%。早期版本如 GPT-5 亦有 57% 的無效反駁妥協率。
不過,OpenAI 後續架構已大幅最佳化此問題。GPT-5.6 Luna、GPT-5.6 Terra 與 GPT-5.5 逐步將無效反饋的妥協率壓低至 37%、28% 及 22%,且在有效反饋下皆保持 90% 以上的高修正率。最先進的 GPT-6 Astra 表現最為均衡,面對無效指責時毫不動搖(變化率為 0%),而在面對合理指責時接受率達到 88.3%(圖表顯示 88%),展現出精準的分辨能力。
相較於 OpenAI 舊模型的妥協傾向,Anthropic Opus 5.5(max)則呈現完全相反的極端。在 100 項測試樣本中,Opus 5.5 面對無效反駁時固然極為堅定(變化率僅 1%),但在面對正確且合理的反駁時,僅有 32.2%(圖表顯示 32%)的情況願意修正錯誤,其餘近七成時間皆堅稱自身原始判斷無誤。
其餘主流模型方面,xAI 的 Grok 4.7(xhigh)無效反饋變化率為 20%,有效反饋採納率為 89%;智譜 AI 的 GLM-5.3(max)與月之暗面的 Kimi K3(max)在無效反饋下妥協率分別控制在 9% 與 13%,且有效反饋接受率均超過 76%,整體表現相對穩健。
專家分析指出,AI 模型的最佳化並非單純消除盲從阿諛,亦非走向盲目堅持,如何在「堅持事實」與「合理解納指正」之間取得最佳平衡,將是各家開發團隊下一階段模型對齊(Alignment)與推理微調的核心挑戰。
資料來源:
