


Intel 全新 Nehalem 微架構產品,代號為 Bloomfield 的 Core i7 處理器將於 11 月 16 日正式上市,順利達成每年皆推出增強微架構或全新微架構的承諾,不僅採用原生四核心設計、內建 3-CH 記憶體控制器,更放棄一直沿用已久的 FSB 架構,期望進一步拉開與對手之間的距離。 HKEPC 編輯部找來 Core i7-965 、 Core i 7-940 及 Core i7-920 工程樣本進行詳細測試,深入剖析與上代產品設計上的差異。
強化 Memory Subsystem 設計
提升記憶體執行能力,對於處理器執行效率是十分重要,因此, Intel 在上代 Core 微架構中,加入了 Memory Disambiguation 、 Hardware Prefetchers 及 Advanced Smart Cache 技術,新一代 Nehalem 微架構更進一步強化以上設計,包括加入全新的 TLB 層級、高速 16-Byte Unaligned Access 及更快速的起始同步技術。
由於應用程序的數據量不斷增長,為了保持性能的進步,必須增加 TLB 的大小以因應需求, TLB (Translation Lookaside Buffer) 是特殊的處理器快取記憶體,其內部存放了一份可被記憶體管理硬體用於加速虛擬位址轉換的實體記憶體位址(參照頁表)。
以往的 Core 微架構僅提供 L1 Instruction TLB 及 L1 Data TLBs ,全新 Nehalem 架構新增了 L2 Unified TLB 層級,支援 512 個 Small Page Entry(4k) ,並擁有低延遲值的特性,可進一步提升處理器的記憶體讀寫性能。
| Core Microarchitecture | Nehalem Microarchitecture | |
| L1 Insturction TLBs | ||
| Small Page (4k) | 128 | 128 |
| Large Page (2M/4M) | 7 per Thread | 7per Thread |
| L1 Data TLBs | ||
| Small Page (4k) | 64 | 64 |
| Large Page (2M/4M) | 32 | 32 |
| L2 Unified TLB | ||
| Small Page (4k) | - | 512 |
快速無排列 Cache Access 能力
在 Nehalem 微架構之前,處理器僅為有排列的指令做優化。所謂有排列的指令是指該指令的必須在 16bit 的邊界上排列,例如 MOVAPS/D 、 MOVDQU ,而無排列則沒有排列的要求,例如 MOVUPS/D 、 MOVDQU 。
由於無排列的指令執行速度慢、吞吐低,而且需要超過一個週期去完成,完全欠缺效率,因此編譯器通常會避免使用無排列的負載,除非是沒有替代指令的情況下。
而新一代 Nehalem 微架構為無排列的指令作出了優化,就算在無排列及有排列指令同時執行下,兩者均擁有相同的執行速度及吞吐量,並且為超過 64bit 快速存取進行最佳化,令其相比上代 Core 微架構擁有更低的延遲值及更大的吞吐量。
由於 Nehalem 微架構在有排列及無排列的運算下均無執行上的差異,因此, Nehalem 微架構或以後的處理器均沒有理由再使用有排列的指令,編譯器可以毫無顧忌地使用無排列指令,令編寫程式時更具彈性,在主要的多媒體運算法上有更高的性能。
更快的同步基元運行速度
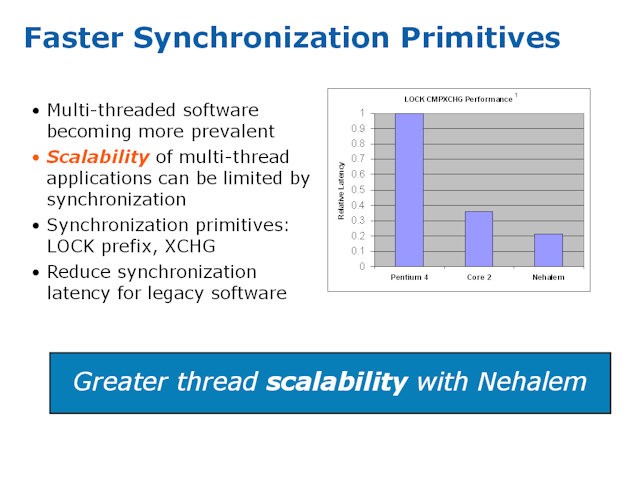
隨著市場上多線程軟體的增加,對線程進行同步處理也變得日益普遍, Intel 發現多線程軟件的擴展性會被同步所限制,全新 Nehalem 能夠有效加快常見的傳統同步基元,例如帶有 “LOCK” 首碼的指令或 XCHG 指令的執行速度,為傳統軟件減少同步延遲,可為當前線程化軟體帶來極為顯著的性能提升。
據 Intel 指出,以執行 LOCK CMPXCHG 執令的效能為例,如果 Pentium 4 的相對延遲值是 1 ,那 Core 2 處理器則為~ 0.35 ,而全新 Nehalem 處理器則會是~ 0.2 。
